v0.3.0 · Apache-2.0 · Windows · macOS · Linux
Veja o que o seu agente realmente fez.
O ThreadlineLM lê os logs de auditoria que o seu agente já grava — compatíveis com OpenAI, OpenTelemetry GenAI ou LiteLLM — e reconstrói a execução: cada chamada, cada chamada de ferramenta, cada nova tentativa. A análise acontece na sua máquina.
Build portátil para Windows · 5,2 MB · sem conta nem telemetria

A execução passou. O log ficou.
Um agente falha e deixa um arquivo: requests, chunks em streaming, chamadas de ferramentas, novas tentativas, um 429 às 14:02:31. O grep entrega linhas. Não diz a que sessão cada uma pertence, qual chamada editou o arquivo nem onde o loop começou.
O ThreadlineLM analisa esse arquivo e reconstrói a execução: a conversa que o modelo viu, as ferramentas que chamou, quanto custou cada chamada. A mesma evidência, legível.
        01
        {

        02
          "id": "evt_0009",

        03
          "ts": "2026-05-17T15:30:09.000Z",

        04
          "client": "eval-runner",

        05
          "model": "gemini/gemini-2.0-flash",

        06
          "status": 429,

        07
          "duration_ms": 95,

        08
          "upstream": { "status": 429 },

        09
          "req_body": {

        10
            "messages": [

        11
              {

        12
                "role": "user",

        13
                "content": "Translate to Spanish: good night."

        14
              }

        15
            ]

        16
          },

        17
          "resp_body": {

        18
            "error": {

        19
              "code": 429,

        20
              "status": "RESOURCE_EXHAUSTED"

        21
            }

        22
          }

        23
        }
Quatro formas de ler o mesmo arquivo.
A linha do tempo é o índice. Todo o resto está a uma tecla: os mesmos eventos, lidos de quatro maneiras, sem reimportar.
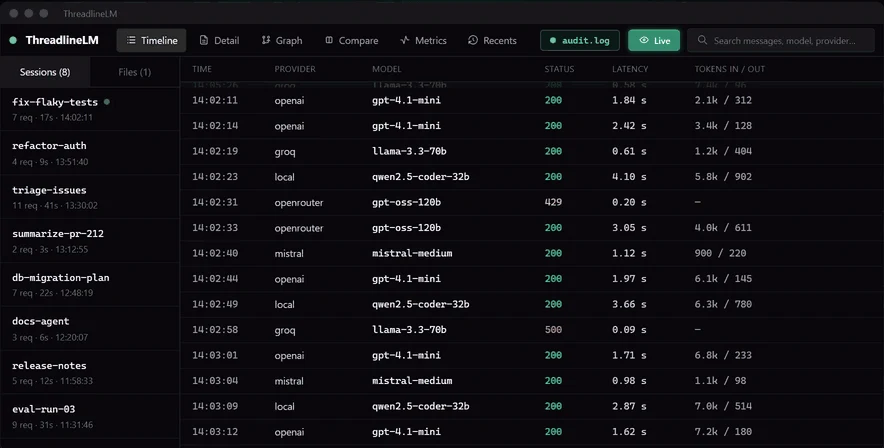
01 Timeline
Cada chamada, em ordem
Provedor, modelo, status, latência e tokens de entrada e saída. Uma chamada com falha mantém o código HTTP em vez de sumir num stack trace.
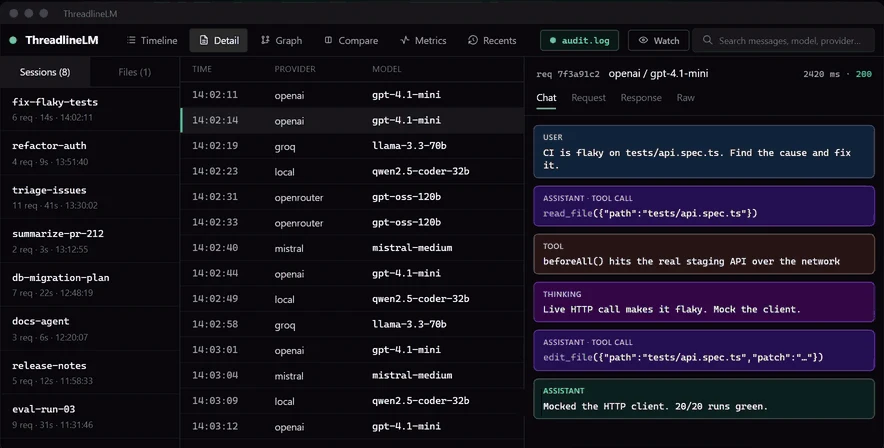
02 Chat
A conversa, reconstruída
Mensagem do usuário, chamada de ferramenta, resultado, raciocínio e resposta final — na ordem em que o modelo realmente recebeu.
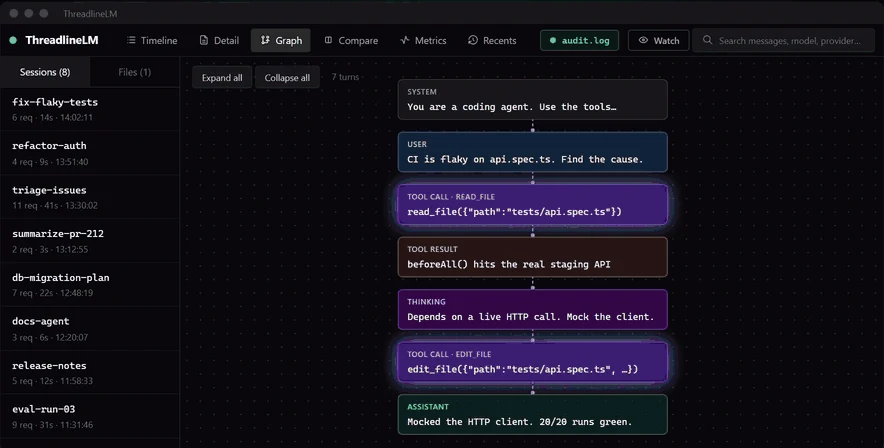
03 Grafo
Ferramentas como fluxo
Nós de sistema, usuário, chamada, resultado, raciocínio e assistente. Loops, novas tentativas e becos sem saída deixam de se esconder no JSON.
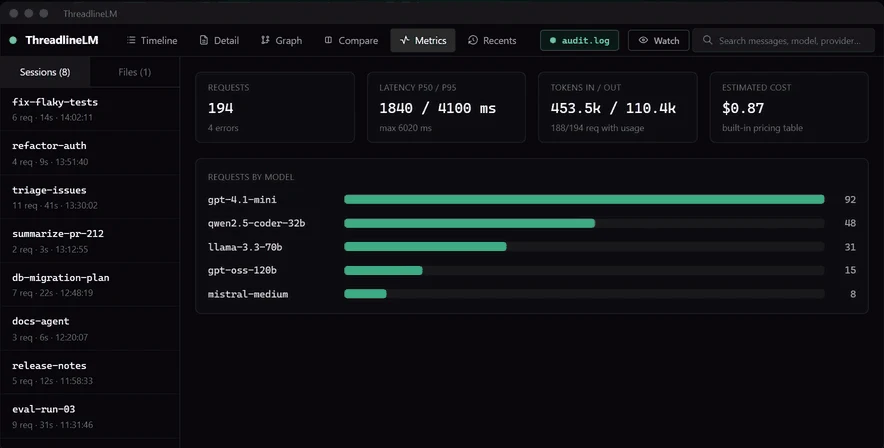
04 Métricas
Latência, tokens, custo
Latência p50/p95/p99, tokens de entrada e saída, custo estimado com tabela de preços embutida e requests por modelo.
Compare é a quinta aba: coloque uma chamada que funciona ao lado de uma quebrada e compare request e resposta, campo por campo.
Ctrl+1…5Seis formatos. Detectados pelo conteúdo, não pela extensão.
Arraste o arquivo para a janela. O parser é escolhido pelos primeiros registros, então .log, .jsonl e .json funcionam igual.
| Formato | O que lê | Exemplo | Eventos |
|---|---|---|---|
| Audit JSONL compatível com OpenAI | Chamadas de ferramentas, streams SSE, raciocínio, tool_use da Anthropic, erros 429 | audit.log | 9 |
| Registros de auditoria como array JSON | Os mesmos registros em um único array | audit-array.json | 3 |
| Spans do OpenTelemetry GenAI | Um span por linha; spans que não são GenAI são ignorados | otel-genai-spans.jsonl | 3 |
| Envelope OTLP/JSON | resourceSpans com atributos KeyValue | otel-genai-otlp.json | 2 |
| StandardLoggingPayload do LiteLLM | Resposta em streaming, tool use, embedding, falha | litellm.jsonl | 5 |
| Log de proxy em texto puro | JSON de auditoria embutido nas linhas de log | proxy-raw.log | 2 |
Todos os exemplos são sintéticos e vêm em inputExample/. Um registro por linha: JSON multilinha formatado ainda não é detectado.
- Watch
- Execuções em andamento
Relê o arquivo a cada 500 ms enquanto o agente trabalha, para acompanhar a execução ao vivo.
- Compare
- Execução boa contra execução quebrada
Request e resposta de duas chamadas, lado a lado, campo por campo.
- Export
- Markdown para o ticket
Busca difusa entre chamadas e exportação da sessão para colar no bug report.
Nada sai da máquina.
Sem conta, sem telemetria, sem nuvem, sem checagem de atualização. A análise roda em Rust, na memória. O log nunca é enviado e nada é gravado além do Markdown que você pedir.
O app não abre nenhum socket. A linha do tempo é montada com o cabo de rede desconectado.
O arquivo é lido, analisado e descartado ao fechar a janela. Sem cache, sem cópia em disco.
Apache-2.0. Os parsers e os comandos IPC são alguns arquivos Rust: leia ou compile o binário você mesmo.
Do arquivo à linha do tempo.
A análise e o agrupamento de sessões ficam no backend Rust; a interface recebe resultados tipados via Tauri IPC.
Os primeiros registros escolhem o parser. Linhas desconhecidas são ignoradas, não fatais.
RustRequests, respostas, chamadas de ferramentas, raciocínio, uso e status.
4 parsersChamadas viram sessões por cliente e janela de 10 minutos.
session.rsOrdem do chat, resultados de ferramentas e arestas do grafo por sessão.
store.tsListas virtualizadas, busca difusa e exportação em Markdown.
React · IPCLeve para uma execução.
Solte inputExample/audit.log na janela: 9 chamadas na linha do tempo, o chat reconstruído, o grafo e a latência p50/p95.
Os builds ainda não são assinados. No Windows, o SmartScreen pede Mais informações → Executar assim mesmo. No macOS, remova a quarentena uma vez: xattr -dr com.apple.quarantine /Applications/ThreadlineLM.app
Início: v0.3.0. Formatos e visões já dão conta do diagnóstico diário; um log com formato incomum ainda pode confundir um parser. Uma issue com uma amostra editada é o melhor relato.
Ou compile
Node 20+, pnpm 10+, uma toolchain estável de Rust e as dependências de sistema do Tauri.